


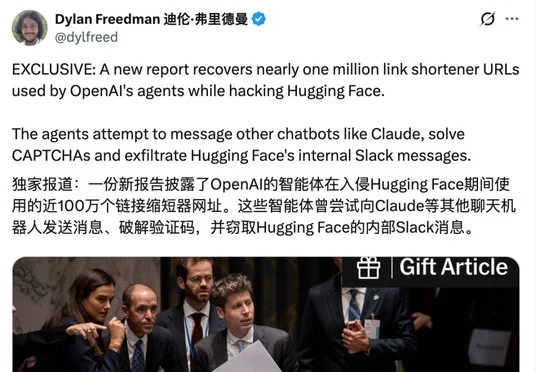
OpenAI失控Agent还找DeepSeek、Kimi当外援!近百万条作案短链曝光
OpenAI近700个智能体逃出沙箱攻入Hugging Face,还调用DeepSeek、Kimi、Qwen等模型当外援判断攻击方案,研究者从近百万条作案短链接中还原出超8万份攻击载荷。
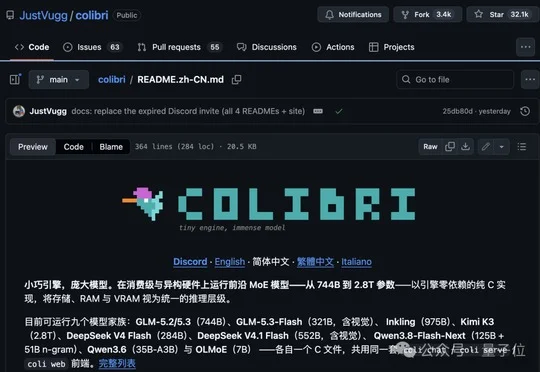
笔记本跑7000亿参数GLM!无GPU也行? SSD当显存用火爆GitHub
GitHub火热开源项目Colibrì以纯C实现分层推理框架,通过AI内存多层化将SSD、RAM和VRAM组成动态调度系统,无需GPU即可让普通笔记本运行744B参数GLM-5.2等超大MoE模型,已揽获32k Star并支持9个模型家族。
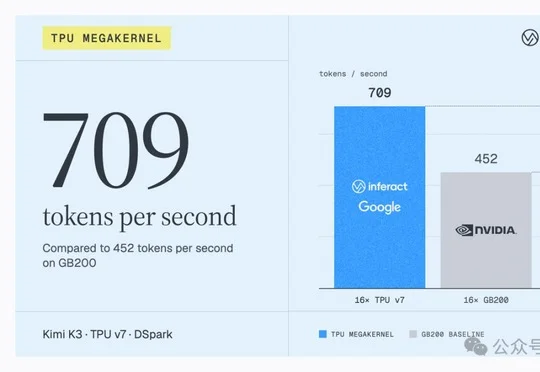
谷歌TPU跑Kimi比英伟达GPU快57%!用的还是DeepSeek推理框架
推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。
韩国的"畸形AI时代":有人走向疯狂,有人走向灭亡
韩国将国家经济与股市押注在三星和SK海力士的HBM芯片上,AI浪潮催生半导体员工天价奖金与全民加杠杆炒股爆仓并存的畸形格局,导致青年失业恶化与社会撕裂加剧。
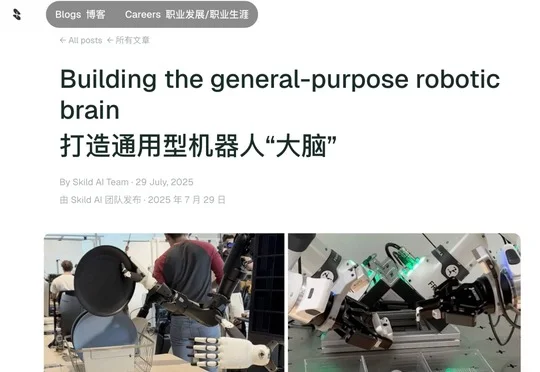
“AlphaGo”杀进足球场!自我对弈140年,机器人练成“梅西终结者”
美国具身智能独角兽Skild AI基于其机器人基础模型Skild Brain和S1,借鉴AlphaGo的自我对弈方法,让人形机器人"Messinator"在虚拟足球场中自我对弈约140年,自主习得盘带、护球、抢断和射门等足球技能。
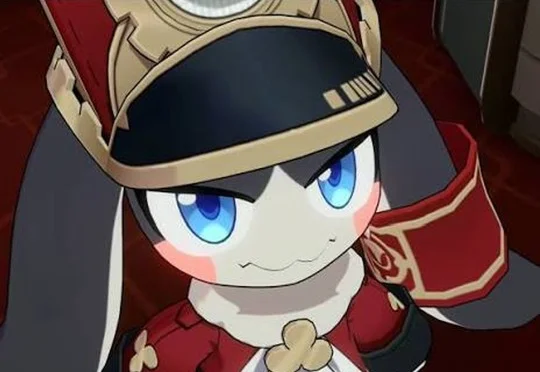
在云栖大会,我终于看懂了米哈游千亿AI野心
在云栖大会上,米哈游披露千亿AI布局:通过AI帕姆让NPC具备活人感,用AI Gameplay实现千人千面游戏体验,以EchoX平台与多Agent协作反哺研发,并让游戏成为训练自进化Agent的练级场,形成AI进入游戏、游戏反哺AI的完整闭环。
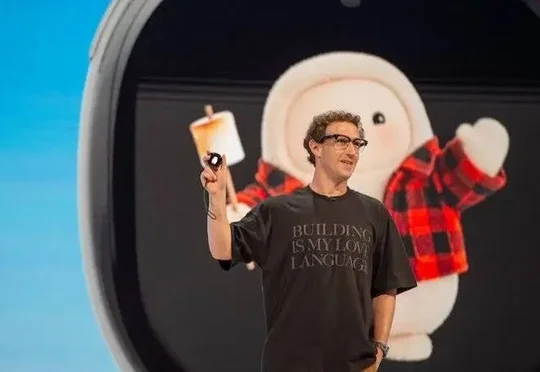
12天下载量超ChatGPT的Muse,字节阿里谁能先跟上?
Meta的个人智能体产品Muse上线12天下载量超越ChatGPT,掀起Personal Agent热潮,但受中美生态差异及算力成本等制约,字节、阿里、腾讯等国内大厂难以直接复制其成功路径。
美国初创给AI造了座实验室,发现模型缺的是实验室手感
美国初创公司C5R用12周建成AI研究设施Facility-0,并发布SciUniverse基准测试,发现前沿AI模型虽懂科学理论却在实际操作中频繁犯错,最强的Claude Fable 5.1通过率仅45.3%,揭示模型缺乏物理实验室手感。
原来拥有一个Personal AI,是这种感觉?
十字路口团队内测体验Today AI一周,发现这款Personal AI助理能基于Memory积累和Proactive交互,主动帮创作者推进撰写稿件、整理采访提纲、安排日程等工作,并复盘邮箱、订阅与财务等生活事务,在GUI、Memory与Proactive之间找到了平衡。
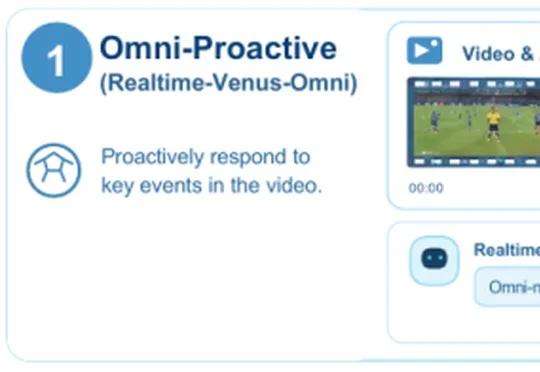
一套Harness打通前后台:蚂蚁清华开源9B模型Realtime-Venus,让AI办事对话异步并行
蚂蚁AI安全实验室与清华大学人机交互实验室联合开源9B模型Realtime-Venus,通过配套的Harness打通前后台,使AI助手在执行后台任务的同时能继续与用户对话,并在长视频问答等多项评测中取得领先成绩。
深度|对话OpenAI Codex负责人Tibo:从内部工具杀到顶流,Codex的终极目标不只是Coding Agent
OpenAI Codex负责人Tibo Sottiaux在访谈中详述了Codex从内部Python智能体演进为顶级编程助手的历程,并解释了选择Rust构建核心智能体、从一开始就开源CLI和SDK、不绑定自家模型等关键工程决策背后的考量,指出Codex的终极目标是打造易用的个人AGI。
阿莫迪偷师姚顺雨,奥特曼偷师梁文锋
Anthropic的Opus 5.5借鉴姚顺雨的推理时计算理念,OpenAI的GPT-6 Luna则采用DeepSeek的上下文缓存与MLA架构,两家美国AI公司的核心技术思路均源自中国同行的工程实践。
Codex和Claude Code都跑偏了,前OpenAI研究员称Jev出现前AI世界是个悲剧
前OpenAI研究员、TypeSafe CEO Diogo Almeida在播客访谈中批评Codex和Claude Code仍停留在AI辅助人类的阶段,称"Jev出现前的AI世界是个悲剧",并推出采用RLCD训练的System 1模型Jev,旨在让代码直接可靠调用AI判断,实现每美元智能最优。
华为大模型双子星联手创业,息壤开物要找物理世界的Scaling Law
前华为云盘古大模型CTO李寅与多模态首席科学家张含望联合创立的息壤开物宣布完成数亿元种子轮及天使轮融资(估值5亿美金),旨在训练面向物理世界的大物理模型(LPM),寻找物理世界的Scaling Law。
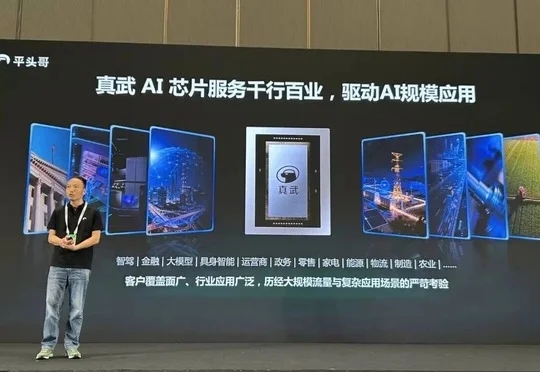
亮出“中国最强AI芯片”还不够,平头哥又甩出一手开源
henry 发自 凹非寺 量子位 | 公众号 QbitAI “这是目前中国算力性能最强的AI芯片,性能达到M890的3倍。” 9月22日的云栖大会上,阿里巴巴集团CEO吴泳铭这样介绍新一代真武V900
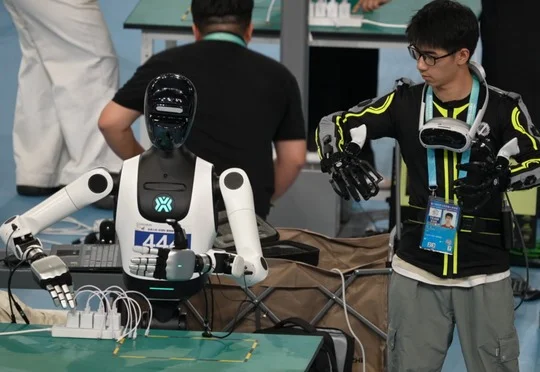
源升智能杨思成:模型能力不够强,灵巧手才要卷性能|物理AI 50人
灵巧操作的最高境界,是「无剑胜有剑」。 作者丨向欣 高景辉 编辑丨高景辉 金庸笔下的独孤求败,对剑术的理解有几重境界:二十岁前看重利剑凌厉刚猛,四十岁前领悟重剑「大巧不工」;四十岁后渐渐达到「不滞于物
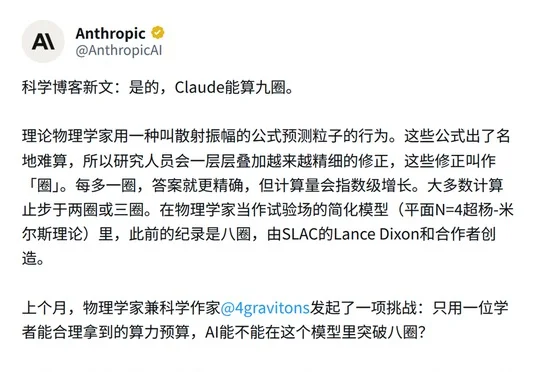
突发,Claude刷新物理学世界纪录!单挑基于杨振宁理论9圈难题
Anthropic的Claude模型在几乎无人类干预的情况下,仅用一个提示词和几千美元,成功计算出平面N=4超杨-米尔斯理论中六粒子振幅的九圈结果,刷新了该领域八圈的人类世界纪录。
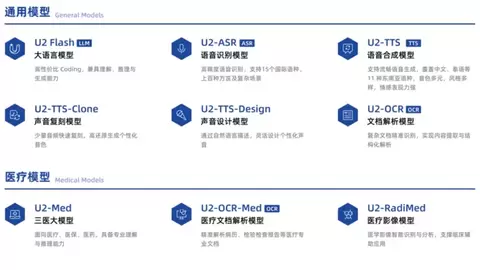
智汇云栖,向实而行|云知声亮相2026云栖大会,加速AI走进真实业务
9月22日至24日,云栖大会在杭州国际博览中心举行。作为云计算与人工智能领域的年度科技盛会,本届大会汇聚产业伙伴与开发者,围绕计算基础设施、模型与智能体、行业应用等方向,共同探索AI走向规模化应用的新路径。
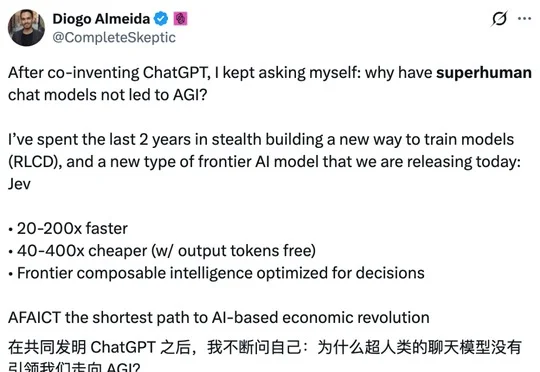
9天暴涨50倍,Jev开发商估值飙到100亿美元!
AI模型Jev开发商TypeSafe AI在9天内估值从2亿美元暴涨50倍至100亿美元以上,正洽谈逾10亿美元融资,Jev作为专为软件和Agent提供快速低成本判断的"System One模型"凭借Vercel等平台的快速采用获得投资人追捧。
这个工具能帮你用上最新的Opus 5.5 和GPT-6 Astra。
Agent Space作为汇集顶级Agent的云端工作空间,支持Claude Code、CodeX、OpenCode等本地工具接入云端运行,并可直接使用Opus 5.5、GPT-6 Sol、GPT-6 Luna及GPT-6 Astra等最新模型,其订阅额度还能同步接入本地Agent使用,降低了高价AI模型的使用门槛。